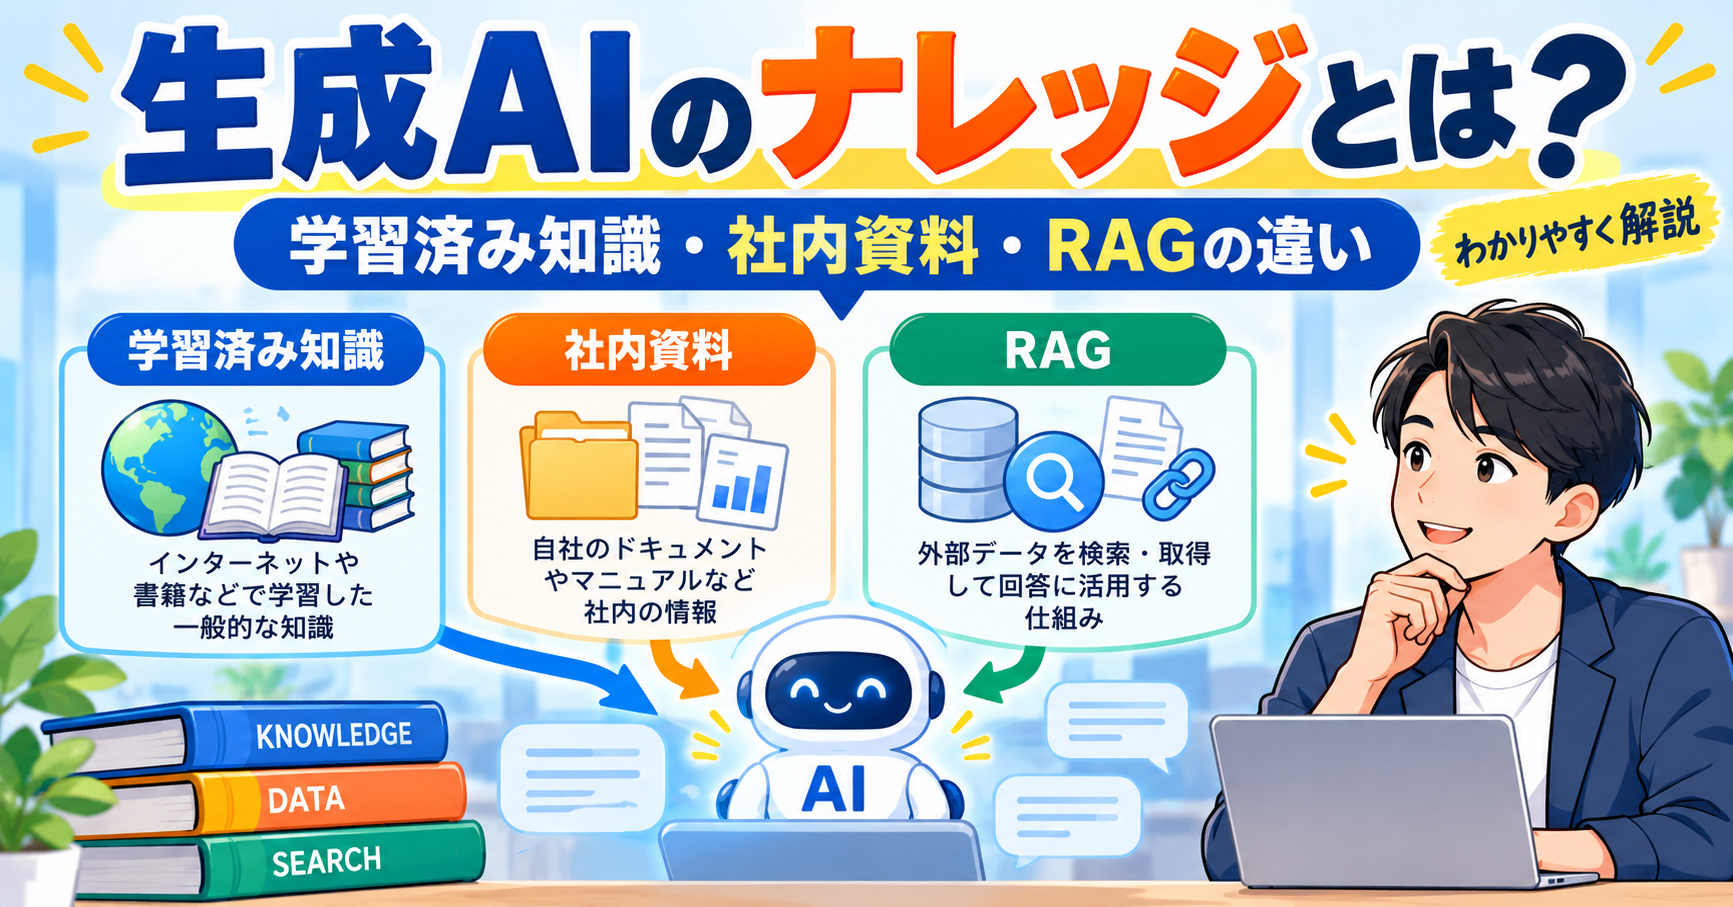
「生成AIのナレッジを入れる」「ナレッジを更新する」と聞いても、何を指すのか分かりにくいものです。
結論からいうと、生成AIにおけるナレッジとは、AIが回答を作るために参照する情報全般を指す言葉です。ただし、実務では主にモデルが学習している情報と、外部から参照させる文書・データの2つを区別して考えることが重要です。
生成AIのナレッジは「AIの記憶そのもの」ではない
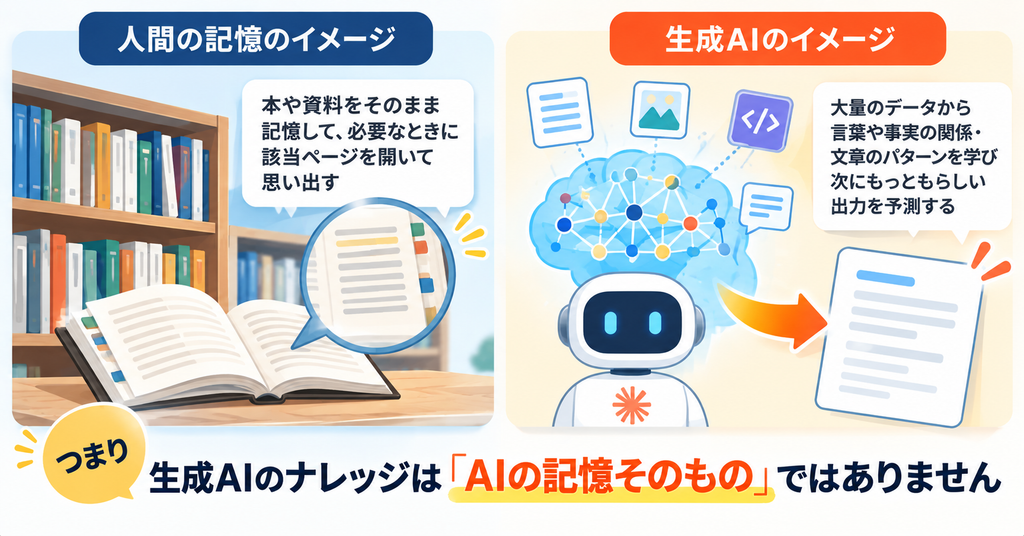
生成AIは、人間のように本や資料をそのまま記憶し、必要なページを開いて回答しているわけではありません。大量のデータから、言葉や事実の関係、文章の続き方などのパターンを学び、それをもとに次にもっともらしい出力を予測します。
そのため、モデル内部にあるナレッジは、正確には学習で得たパターンや関連性です。情報をそのまま保管した検索可能なデータベースとは性質が異なります。
「ナレッジ」が指す3つのもの
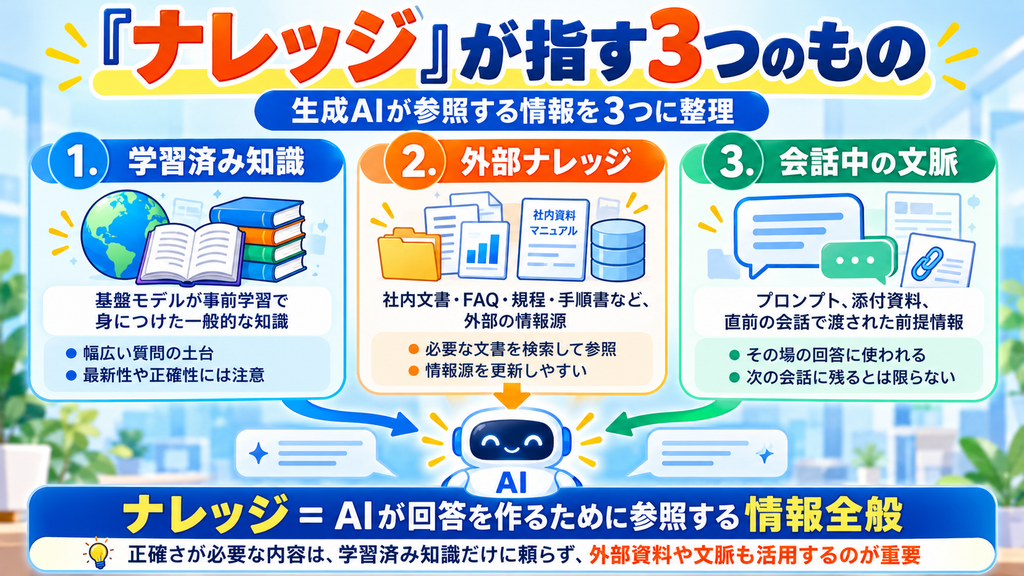
1. 基盤モデルが学習している一般的な知識
これは、生成AIが事前学習を通じて身につけた、言語表現、一般常識、専門分野の概念などです。幅広い質問に答えられる土台になります。
ただし、学習済みの知識には更新時点があります。また、回答は確率的に生成されるため、もっともらしくても誤っている場合があります。最新情報、社内ルール、契約内容のように正確さが求められる内容は、学習済み知識だけに頼らないほうが安全です。
2. 社内文書やマニュアルなどの外部ナレッジ
企業で「AIにナレッジを入れる」という場合、多くはこの意味です。就業規則、製品仕様、FAQ、手順書、議事録、規程集などを、AIが質問に応じて参照できる状態にします。
この外部ナレッジは、モデルそのものを再学習するのではなく、必要な文書を検索して回答時に渡す仕組みで使われることが一般的です。情報源を更新すれば、回答の根拠となる内容も更新しやすい点が大きな特徴です。
3. 会話中に渡された文脈
プロンプトに書いた条件、添付した資料、直前までの会話も、その場でAIが参照する情報です。これも広い意味ではナレッジのように扱われますが、恒久的な知識とは限りません。
たとえば「この商品は法人向けで、価格は非公開です」と会話で伝えれば、AIはその前提を使って文章を作れます。しかし、新しい会話でも同じ前提を使えるかは、利用しているサービスの設定や機能によって異なります。
RAGとは、外部ナレッジを回答に使う代表的な仕組み
外部ナレッジを生成AIに使わせる代表的な方法が、RAG(Retrieval-Augmented Generation:検索拡張生成)です。
RAGでは、ユーザーの質問に関連する資料をナレッジベースから検索し、その内容を質問と一緒にAIへ渡して回答を作らせます。Google Cloudの公式ドキュメントでも、RAGは関連情報を検索してプロンプトに追加し、回答を検証可能な情報源に結び付けるための手法として説明されています。
- ユーザーが質問する
- システムがナレッジベースから関連資料を探す
- 見つかった資料の要点をAIに渡す
- AIが資料を踏まえて回答を生成する
つまり、RAGにおけるナレッジとは、AIの頭の中に永久に覚え込ませる情報というより、質問のたびに根拠として取り出す情報源です。
ナレッジベースとファインチューニングは別物
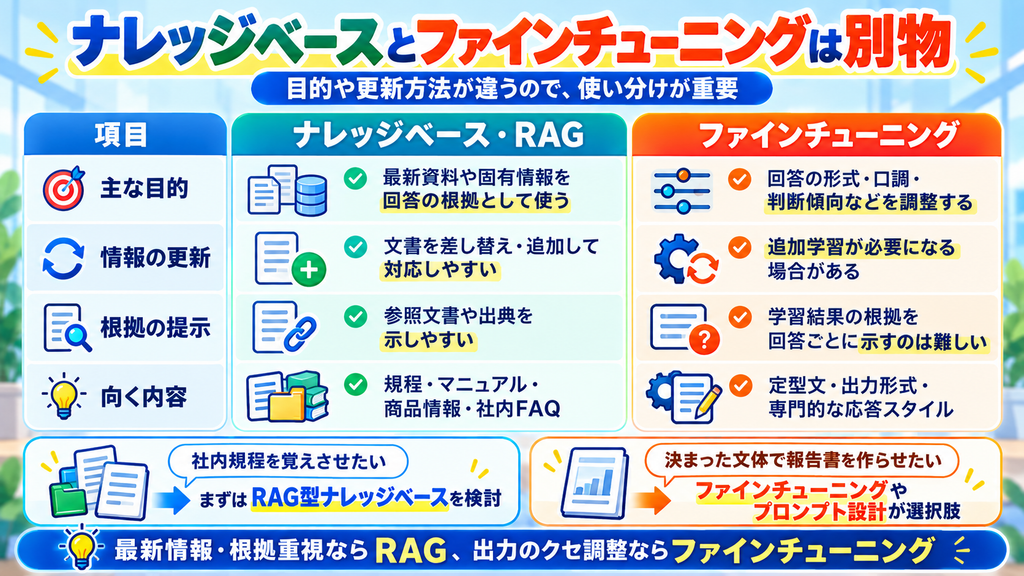
| 項目 | ナレッジベース・RAG | ファインチューニング |
|---|---|---|
| 主な目的 | 最新資料や固有情報を回答の根拠として使う | 回答の形式・口調・判断傾向などを調整する |
| 情報の更新 | 文書を差し替え・追加して対応しやすい | 追加学習が必要になる場合がある |
| 根拠の提示 | 参照文書や出典を示しやすい | 学習結果の根拠を回答ごとに示すことは難しい |
| 向く内容 | 規程、マニュアル、商品情報、社内FAQ | 定型文、出力形式、専門的な応答スタイル |
「社内規程を覚えさせたい」という要望なら、一般的にはまずRAG型のナレッジベースを検討します。一方で、「必ず決まった文体で報告書を作らせたい」といった要望では、ファインチューニングやプロンプト設計が選択肢になります。
ナレッジの品質が、回答の品質を左右する
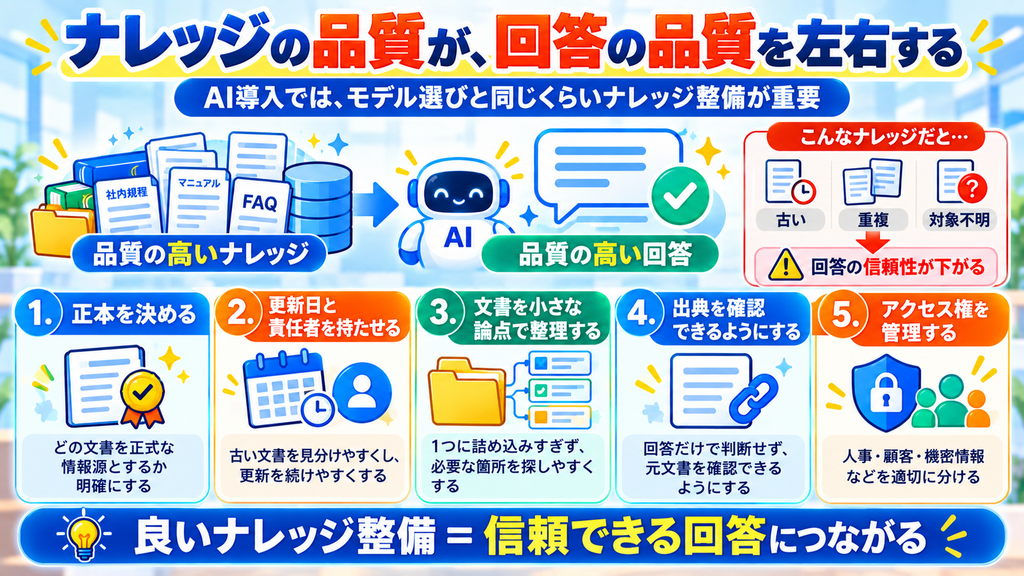
外部ナレッジを用意しても、内容が古い、重複している、対象者が不明確といった状態では、回答の信頼性は上がりません。AI導入では、モデル選びと同じくらいナレッジの整備が重要です。
- 正本を決める:どの文書を正式な情報源とするかを明確にします。
- 更新日と責任者を持たせる:古い文書を見分け、更新を継続しやすくします。
- 文書を小さな論点で整理する:1つの資料に情報を詰め込みすぎず、質問に対応する箇所を探しやすくします。
- 出典を確認できるようにする:回答だけで判断せず、元文書を確認できる設計にします。
- アクセス権を管理する:人事・顧客・機密情報などは、誰が参照できるかを分けます。
ナレッジがあっても、AIの回答をそのまま確定情報にしない
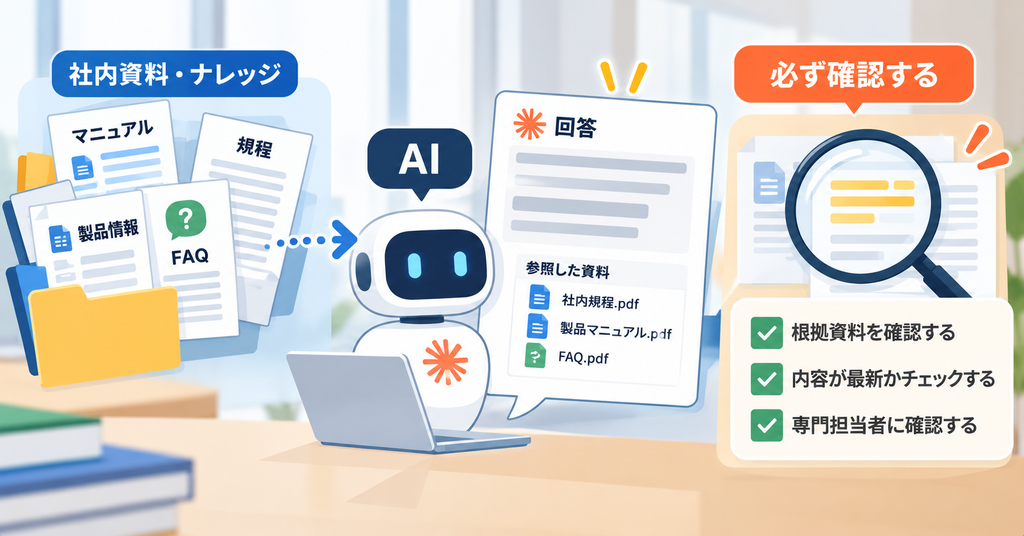
RAGやファイル検索を使うと、回答を資料に基づけやすくなります。しかし、検索漏れ、文書の古さ、文脈の読み違い、AIによる要約ミスなどは起こりえます。
特に法務、労務、医療、経理、セキュリティのように誤りの影響が大きい領域では、回答を最終判断にせず、根拠資料と担当者による確認を組み合わせることが大切です。
まとめ:生成AIのナレッジとは「回答の材料」と「根拠」
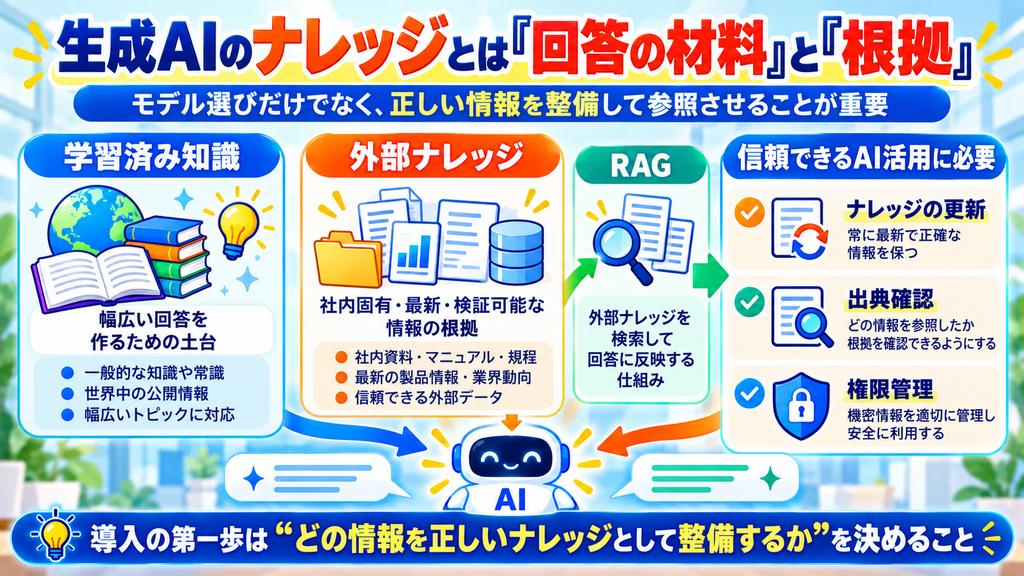
生成AIのナレッジは、ひとことで言えばAIが回答を作るための情報の土台です。ただし、実務で重要なのは「AIが学習済みの情報」と「質問時に参照する外部資料」を混同しないことです。
- 学習済み知識は、幅広い回答を作るための土台
- 外部ナレッジは、社内固有・最新・検証可能な情報を使うための根拠
- RAGは、外部ナレッジを検索して回答に反映する仕組み
- 信頼できるAI活用には、ナレッジの更新、出典確認、権限管理が欠かせない
生成AIの導入を検討する際は、「どのモデルを使うか」だけでなく、どの情報を正しいナレッジとして整備し、どのように参照させるかを決めることから始めるとよいでしょう。
参考資料
- Google Cloud:RAG を使用してレスポンスをグラウンディングする(RAGとグラウンディングの概要)
- Google Cloud:生成 AI(RAGで関連情報をプロンプトに追加する仕組み)
- OpenAI Help Center:ファイルアップロード FAQ(アップロード文書を扱う機能の概要)