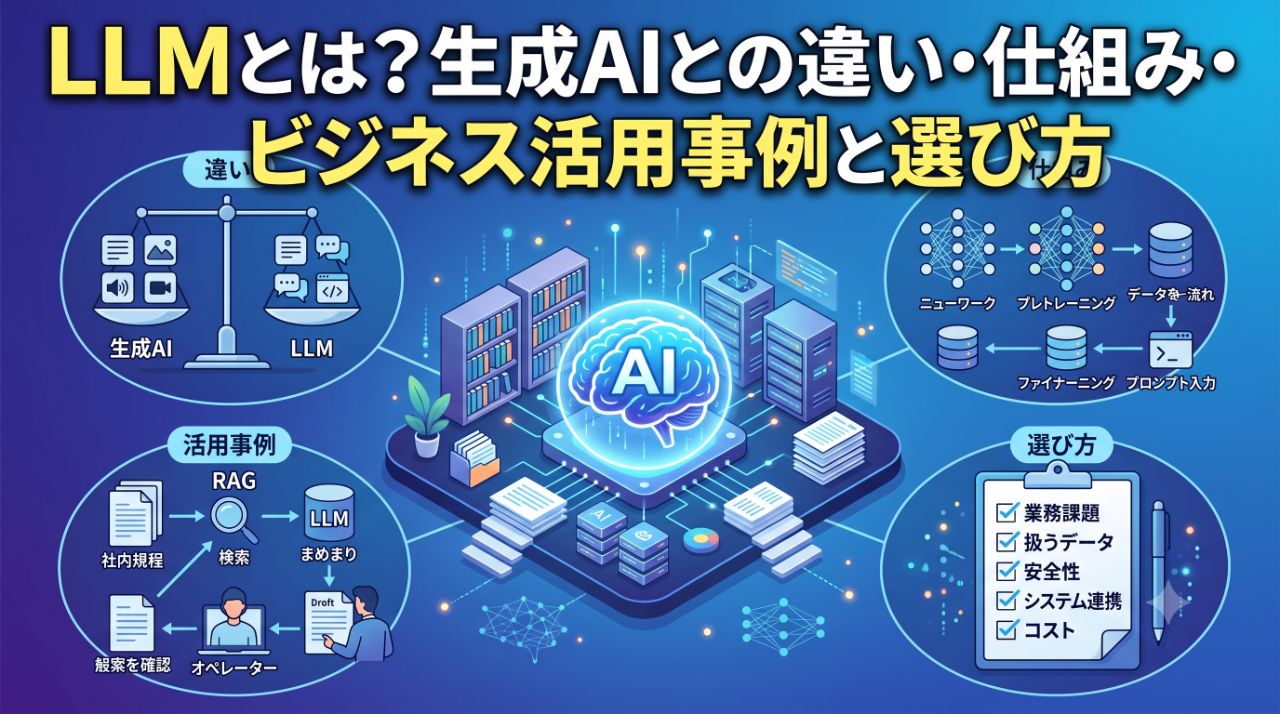
「LLMは生成AIと何が違うのか」「自社ではどのように使えばよいのか」と迷う方は多いのではないでしょうか。結論からいうと、LLMは人間の言葉を扱うことに強いAIモデルであり、文章作成だけでなく、社内文書の検索、問い合わせ対応、議事録の要約、コード作成などに活用できます。導入時は、モデル名だけで比較するのではなく、業務課題・扱うデータ・安全性・既存システムとの連携を基準に選ぶことが重要です。
LLMとは何か
LLMは「Large Language Model」の略で、日本語では大規模言語モデルと呼ばれます。大量のテキストやコードから、言葉どうしのつながりや文脈のパターンを学習し、質問への回答、要約、翻訳、文章作成、分類などを行うAIです。
基本的な動きは、入力された指示や文章を細かな単位で読み取り、「次に続く可能性が高い言葉」を予測することです。この予測を繰り返すことで、自然な文章や回答を生成します。人間のように内容を完全に理解しているわけではありませんが、幅広い言語タスクを一つの仕組みで処理できる点が大きな特徴です。
LLMと生成AIの違い
| 用語 | 意味 | 主な対象 |
|---|---|---|
| 生成AI | 新しい文章、画像、音声、動画、コードなどを作るAIの総称 | テキスト、画像、音声、動画など |
| LLM | 言語の理解・生成に特化した大規模なAIモデル | 文章、会話、コードなど |
| 基盤モデル | 大量データで事前学習され、多様な用途に応用できる土台となるモデル | 言語、画像、音声、複数形式のデータなど |
つまり、LLMは生成AIを支える代表的な技術の一つです。ただし、生成AIには画像生成や音声生成なども含まれるため、すべての生成AIがLLMというわけではありません。LLMは、文章生成、翻訳、要約、チャットボット、社内検索といった言語中心の業務で特に活用しやすい技術です。
LLMの基本的な仕組み
1. 大量のデータで事前学習する
LLMは、公開テキスト、書籍、記事、コードなどを含む大量のデータをもとに、言葉の使われ方や関係性を学びます。この段階を事前学習と呼びます。事前学習済みのモデルは、幅広い質問や文章作成に対応できる汎用的な土台になります。
2. 指示に従いやすいように調整する
事前学習後のモデルには、人が評価した回答例などを用いて、指示に従いやすく、安全性に配慮した応答をしやすくする調整が加えられます。これにより、「3行で要約して」「表形式で整理して」といった業務上の指示に対応しやすくなります。
3. 入力文に応じて回答を生成する
利用時には、ユーザーの質問、目的、出力形式、参考情報などを入力します。LLMはその文脈をもとに、もっとも適切と考えられる回答を生成します。この入力指示をプロンプトと呼びます。
LLMでできること・苦手なこと
得意な業務
- メール、提案書、FAQ、商品説明、議事録などの下書き作成
- 長い文書の要約、比較、分類、要点抽出
- 多言語への翻訳や表現の調整
- 社内規程やマニュアルに基づく質問応答
- 問い合わせ内容の要約、回答案の作成、担当部署への振り分け
- ソースコードのたたき台作成、レビュー補助、テスト観点の洗い出し
注意が必要な点
- もっともらしい誤情報を生成する場合があります。これはハルシネーションと呼ばれます。
- 最新情報や社内固有の情報を、モデルが必ず知っているとは限りません。
- 個人情報、機密情報、顧客情報を無条件に入力すると、社内規程や契約条件に抵触するおそれがあります。
- 法務、医療、金融、人事評価などの高リスクな判断を、LLMだけに任せるべきではありません。
そのため、重要な回答には根拠となる文書を表示し、人による確認・承認の工程を残すことが実務では重要です。
ビジネスでの代表的な活用事例
社内ナレッジ検索・問い合わせ対応
就業規則、製品マニュアル、営業資料、過去の問い合わせ履歴などを対象に、社員が自然な文章で質問できる仕組みです。「出張精算の期限は?」「この製品の設定手順は?」といった質問に対し、関連する社内文書をもとに回答します。情報を探す時間を減らし、担当者への問い合わせ集中を抑える効果が期待できます。
カスタマーサポートの支援
顧客からの問い合わせを要約し、回答案を作成したり、ナレッジベースから関連情報を提示したりする用途です。最終送信はオペレーターが確認する運用にすれば、応対品質を保ちながら記録作成や定型回答の負担を減らせます。
営業・マーケティング
商談メモからの提案内容の整理、顧客別メールの下書き、広告文案の作成、アンケート自由記述の分類、競合情報の要約などに活用できます。完成品をそのまま出すのではなく、担当者の作業を速くする「たたき台」として使うと導入しやすくなります。
バックオフィス
契約書や請求書に含まれる情報の抽出、稟議書の要約、社内規程に沿ったチェック項目の洗い出し、採用候補者との連絡文案作成などが候補です。判断根拠の記録と人による確認を組み合わせることが欠かせません。
ソフトウェア開発・IT運用
コードのたたき台作成、レビュー補助、仕様書からのテストケース案作成、障害報告の要約、運用手順の検索などに活用できます。機密コードや認証情報の扱いは、利用サービスの設定と社内ルールを確認したうえで進めましょう。
社内文書を活用するならRAGを検討する
社内固有の情報を扱う場合は、RAG(Retrieval-Augmented Generation:検索拡張生成)が有力な方法です。RAGは、質問に関連する社内文書を先に検索し、その内容をLLMに渡して回答させる仕組みです。
モデルそのものを再学習させなくても、更新された規程や最新の製品資料を参照させやすい点がメリットです。また、回答とともに参照元の文書を示す設計にすると、利用者が内容を確認しやすくなります。ただし、検索対象の文書が古い、アクセス権が適切に設定されていない、文書の分割方法が不適切といった場合には、回答品質や安全性が下がるため注意が必要です。
自社に合うLLMの選び方
「最も高性能なモデル」を選ぶことが、必ずしも最適解ではありません。まずは対象業務を明確にし、実際のデータと評価基準で比較しましょう。
- 業務目的を一つに絞る
最初から全社活用を目指すのではなく、「問い合わせ後処理を短縮する」「社内規程の検索時間を減らす」など、効果を測れる業務から始めます。 - 必要な能力を定義する
日本語の自然さ、要約精度、長文読解、コード生成、画像・PDFの扱い、多言語対応など、業務に必要な能力を洗い出します。 - データ保護と運用要件を確認する
入力データが学習に使われるか、保存期間、暗号化、アクセス制御、監査ログ、契約条件、利用地域などを確認します。 - 連携のしやすさを確認する
チャット画面だけで使うのか、既存のCRM、グループウェア、文書管理、問い合わせ管理、基幹システムと連携するのかを決めます。 - コストと速度を実データで測る
利用量に応じた料金、応答時間、同時利用数、長文入力時のコストを確認します。 - 品質・安全性を評価する
正答率だけでなく、根拠の提示率、誤答時の挙動、禁止情報の出力、利用者の修正量などをテストします。
提供形態ごとの考え方
| 選択肢 | 向いているケース | 確認したい点 |
|---|---|---|
| クラウド型の商用LLM | 短期間で試したい、高度な性能を使いたい、運用負荷を抑えたい | データ利用条件、料金、API連携、リージョン、管理機能 |
| クラウド基盤に統合されたLLM | 既存クラウドのID管理、監査、データ基盤と連携したい | 既存環境との統合性、権限管理、検索基盤、監視機能 |
| オープンウェイトのLLM | 自社環境での運用や細かなカスタマイズを重視したい | ライセンス、GPUなどの運用基盤、保守体制、性能評価、安全対策 |
機密性が高いからといって、必ずしも自社運用が唯一の選択肢とは限りません。クラウド型でも、契約・設定・アクセス制御・データ保持の条件が要件に合う場合があります。反対に、自社運用では自由度が高まる一方、インフラ、更新、監視、脆弱性対応を継続して担う必要があります。
導入をスムーズに進める5ステップ
- 対象業務を選ぶ
定型作業が多く、文章や文書を扱い、効果を測定しやすい業務を選びます。 - 現状の作業時間と品質を記録する
導入前の処理件数、所要時間、修正回数、問い合わせ件数などを測定します。 - 小さく試す
限定部署・限定データ・限定期間で検証し、実務での回答品質を確かめます。 - ルールを整備する
入力禁止情報、承認が必要な出力、利用者教育、ログ管理、障害時の対応を定めます。 - 効果を見て拡大する
時間削減だけでなく、品質、従業員満足度、顧客満足度、リスク発生件数も見ながら対象業務を広げます。
まとめ
LLMは、言語を扱う生成AIの中核技術であり、文章作成だけでなく、検索、要約、問い合わせ対応、開発支援など幅広い業務に活用できます。成功のポイントは、LLMを単独で導入することではなく、業務目的に合わせて社内データ、検索、権限管理、人による確認を組み合わせることです。
まずは「誰の、どの作業を、どれだけ改善したいか」を明確にし、少量の実データで検証してみましょう。その結果をもとに、必要な性能・安全性・コストを満たすLLMと導入方式を選ぶと、実装を進めやすくなります。
参考資料
- Google Cloud:What are foundation models?(基盤モデル、LLM、生成AIの関係)
- Microsoft Learn:Design a secure multitenant RAG inferencing solution(社内・顧客データを扱うRAGの構成とアクセス制御)
- IBM Think:What Are Large Language Models (LLMs)?(LLMの用途と特徴)
- OpenAI:Business data privacy, security, and compliance(法人向けデータの取り扱いに関する情報)